Nova feature falha, mas os clientes não são impactados
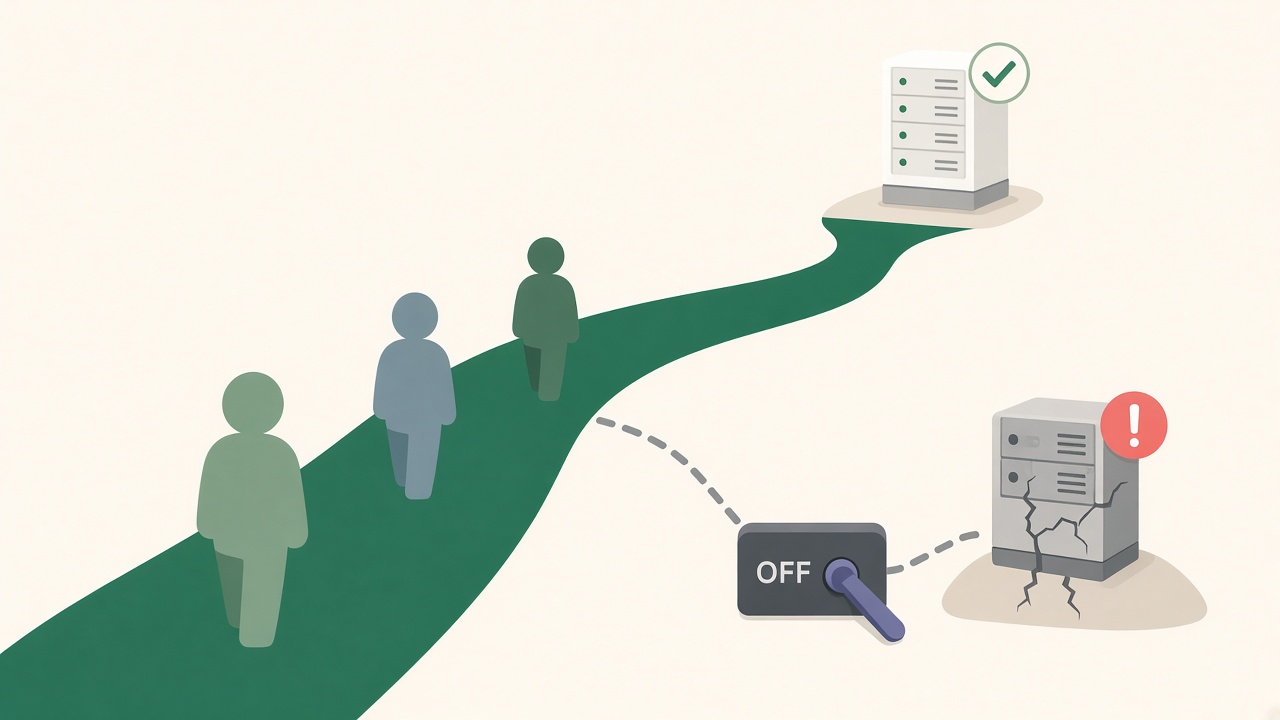
Já pensou desenvolver uma feature inteira e descobrir, na hora do deploy, que uma dependência de outro time ainda não foi para produção?
Bom, isso aconteceu com nosso time. Mas, apesar disso, nenhum cliente foi impactado.
E sim, isso envolve o uso do feature toggle. Mas o que eu queria trazer aqui não é só a tecnologia, e sim a ideia por trás dela.
Separar o deploy da ativação
O feature toggle, também conhecido como feature flag, é um mecanismo que permite controlar se determinado comportamento da aplicação está habilitado ou não.
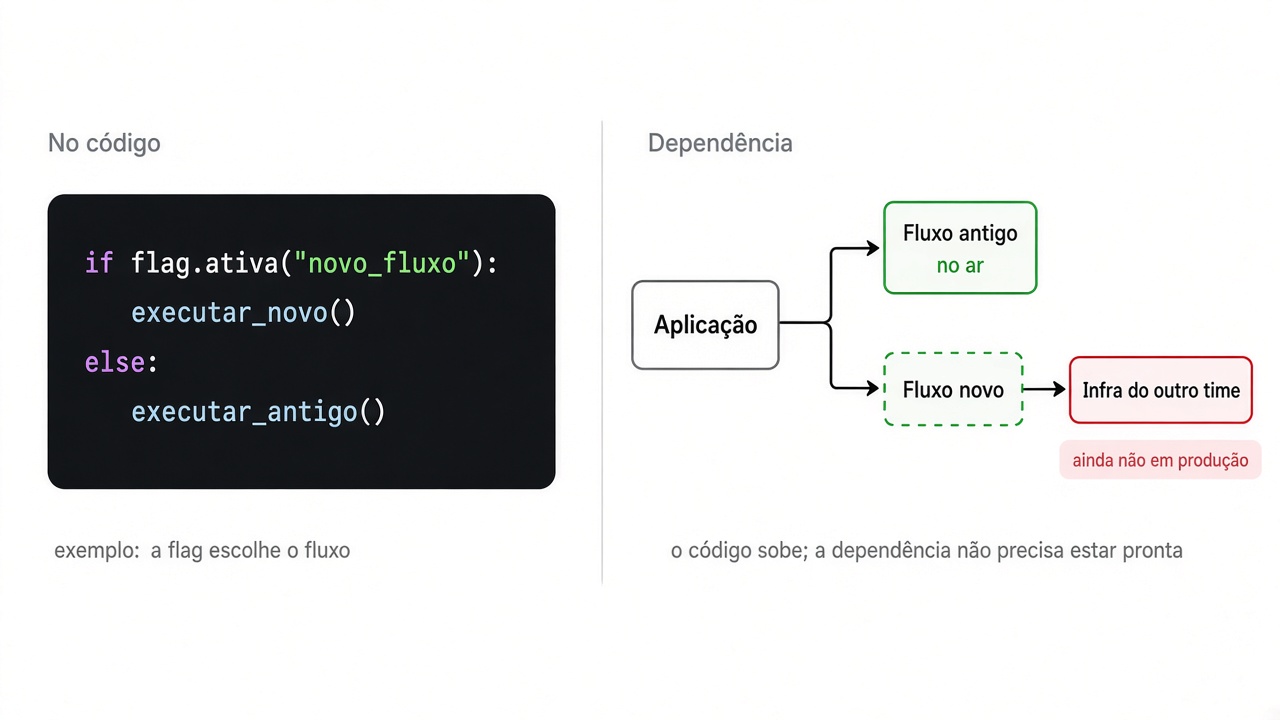
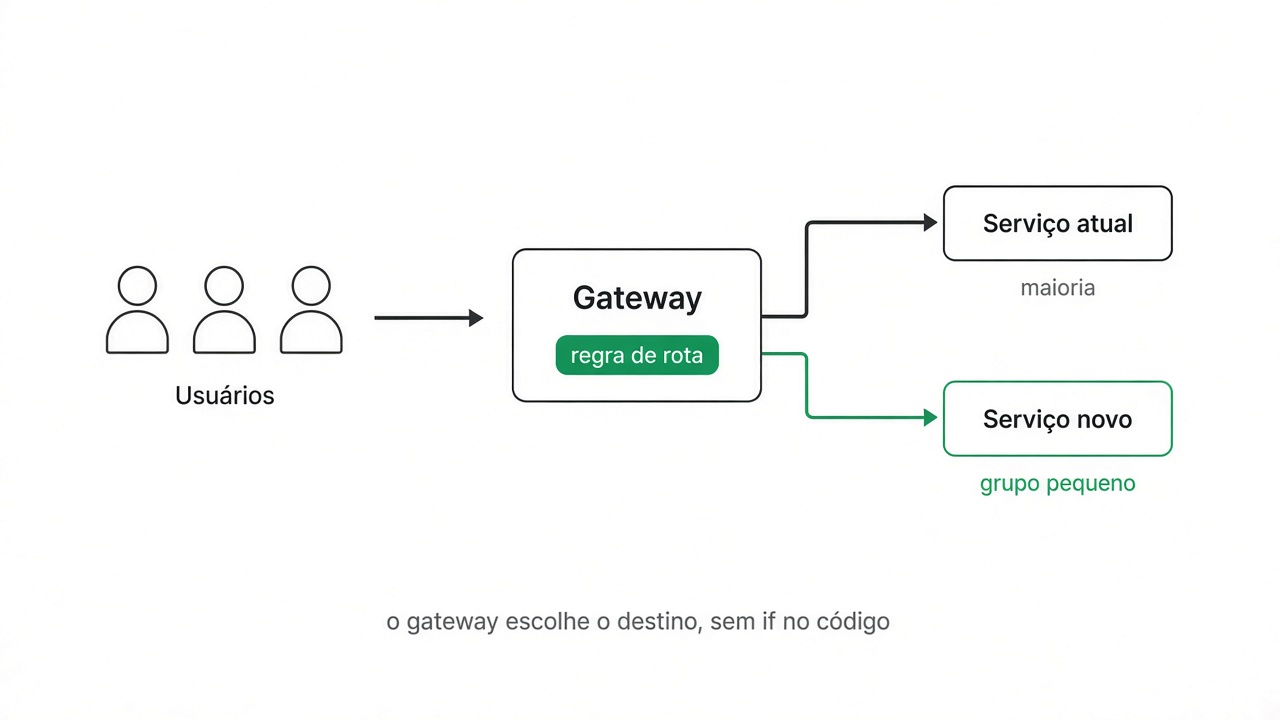
Isso pode ser feito de diferentes formas. Podemos controlar o direcionamento de usuários pela infraestrutura, por exemplo, ou implementar uma condição no código para decidir qual fluxo executar.
A ideia mais interessante, porém, é outra: o código pode estar em produção sem que a nova funcionalidade esteja disponível para os usuários.
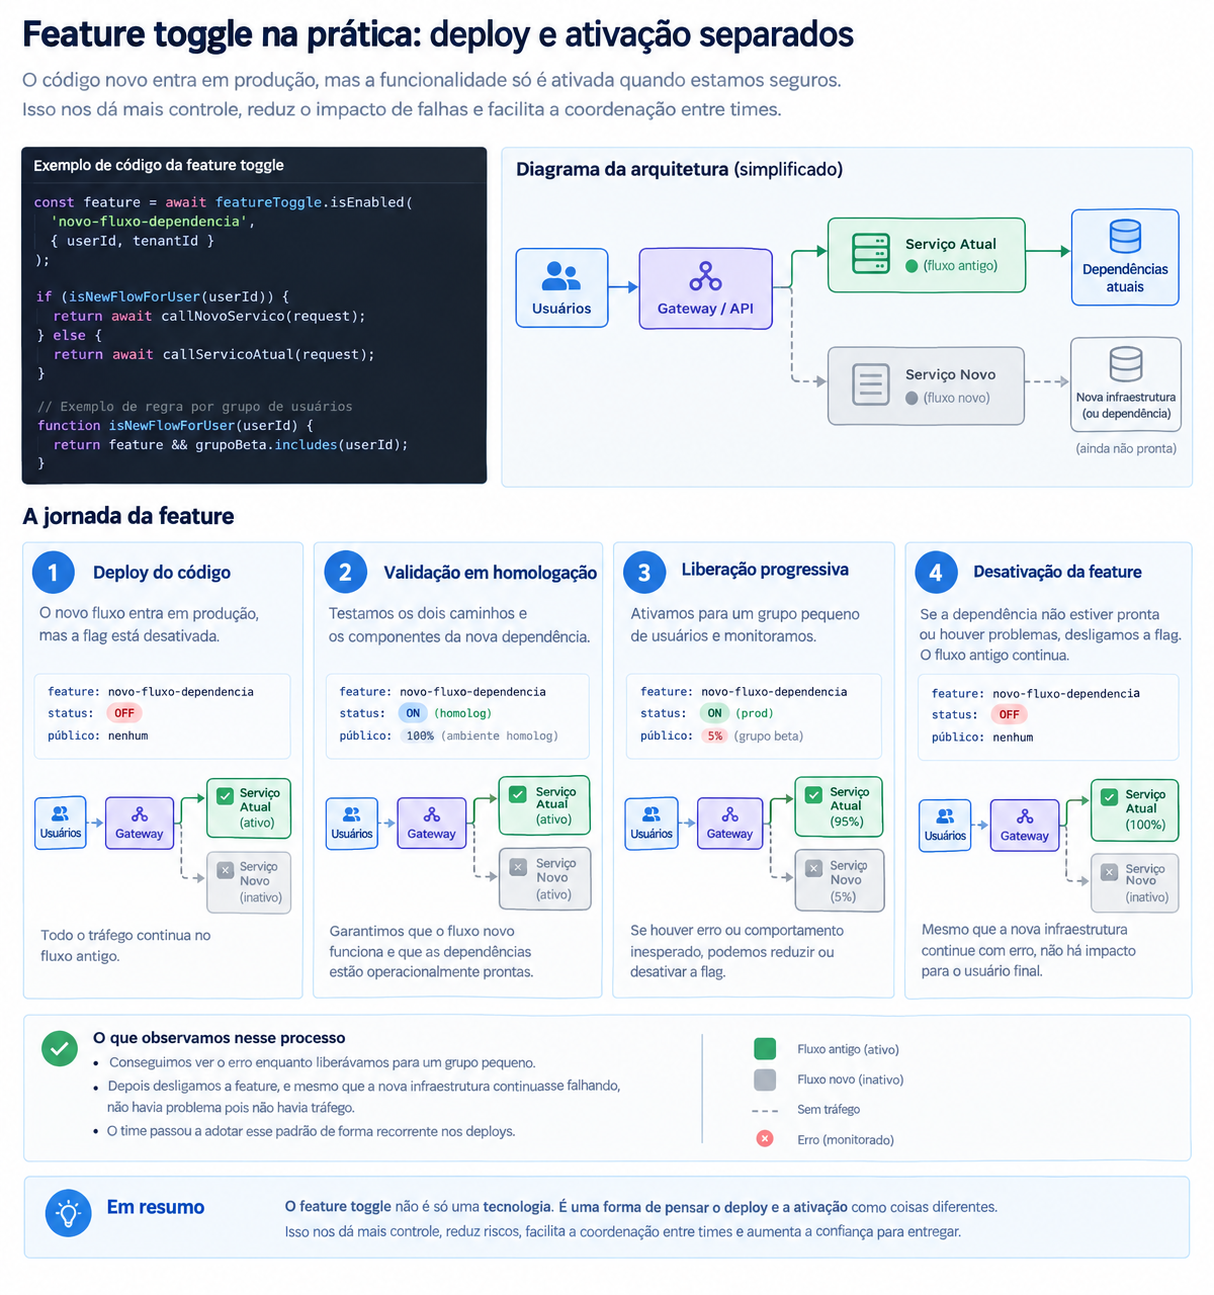
Em vez de fazer um deploy e já substitui imediatamente o comportamento antigo com a nova feature, podemos fazer os dois caminhos coexistirem. O código novo entra em produção, mas permanece desligado até que estejamos seguros para ativá-lo.
Isso muda a maneira como pensamos sobre deploy. Não precisamos mais tratar a publicação do código e a liberação da funcionalidade como uma única operação.
Como isso nos protegeu de uma falha em produção
No nosso caso, a ideia foi permitir que o fluxo antigo e o novo convivessem.
Em homologação, testamos os dois caminhos. Em produção, a ativação foi planejada para acontecer de forma faseada e progressiva, liberando a funcionalidade para grupos controlados de usuários enquanto a quase totalidade dos usuários seguia para o fluxo antigo.
Em contra partida em uma abordagem na qual o deploy substitui imediatamente o comportamento anterior, um problema no novo fluxo poderia exigir o rollback da aplicação para recuperar o comportamento anterior. Isso significaria reverter um código que já havia passado por homologação e pelo processo de release.
Com o feature toggle, tínhamos outra opção: desligar o novo fluxo e manter a execução pelo caminho antigo.
O código continuava em produção, mas o comportamento que dependia daquela infraestrutura permanecia desativado até que estivéssemos seguros para ativá-lo.
Durante a liberação controlada, conseguimos observar o comportamento do novo fluxo e identificar o problema na dependência. Como a ativação era controlada pela flag, foi possível desativar o novo caminho e manter a execução pelo fluxo antigo.
Mesmo com a nova infraestrutura apresentando erros, não foi necessário reverter o deploy. Desativamos a flag e mantivemos a execução pelo fluxo antigo, preservando o funcionamento da aplicação sem impacto para os clientes.
Depois de corrigir o problema na nova infraestrutura, fizemos um novo deploy para disponibilizar a solução.
E se a dependência for um banco ou um Kafka?
O mesmo raciocínio pode ser aplicado a outros cenários.
Imagine que você precise introduzir uma nova integração com um banco de dados ou publicar mensagens em um novo tópico Kafka. A implementação pode estar pronta, mas ainda existem configurações, permissões, conectividade ou recursos de infraestrutura que precisam ser preparados.
Se a implementação e a ativação acontecerem ao mesmo tempo, qualquer problema nessa dependência pode comprometer a funcionalidade ou até afetar o fluxo existente.
Uma alternativa é preparar a aplicação para os dois cenários.
Primeiro, fazemos o deploy do código com o novo comportamento desativado. Podemos validar configurações, conectividade e outros aspectos que não dependam da execução completa da funcionalidade. Depois que as dependências estiverem prontas e os testes necessários tiverem sido realizados, ativamos o novo fluxo.
Mas existe um detalhe importante: isso não significa que basta colocar um if na aplicação e considerar o problema resolvido.
A inicialização do sistema, a criação de conexões e outros efeitos colaterais também precisam ser validados. Se a aplicação tentar acessar a nova dependência antes mesmo de consultar a flag, o mecanismo não vai proteger esse cenário.
O mesmo vale para inicializadores, produtores Kafka e outros componentes que possam tentar utilizar a dependência independentemente de a funcionalidade estar habilitada.
Uma forma de validar esse comportamento é testar em homologação com a nova dependência indisponível, preservando as dependências necessárias para o funcionamento do fluxo antigo.
Se a aplicação cair na inicialização ou deixar de atender pelo caminho antigo, a flag não chegou a proteger o cenário que queremos controlar.
A ideia só se sustenta quando o sistema continua de pé e consegue atender pelo fluxo antigo mesmo sem a nova dependência.
O importante é reproduzir a falha que queremos evitar. Se o fluxo antigo também depende do mesmo banco ou cluster Kafka, indisponibilizar esse recurso por completo pode derrubar os dois caminhos. Nesse caso, o teste deve simular a indisponibilidade do recurso específico utilizado pelo novo fluxo, ou outra condição equivalente que permita verificar se o comportamento antigo continua funcionando.
Quando a flag não é suficiente: entregas preparatórias
Quando esse teste falha, ou quando o time ainda não tem uma plataforma de flags, dá para separar o deploy da ativação de outro jeito: quebrar a mudança em entregas menores.
Uma delas pode ser apenas preparatória. O serviço novo sobe, o tópico existe, a conexão está configurada, mas nenhum fluxo de usuário passa por ali.
Assim, você consegue validar os componentes e usar métricas, logs e testes de conectividade para verificar se as dependências necessárias estão disponíveis em produção. A ativação fica para um deploy seguinte.
Essa estratégia também pode ser útil quando precisamos coordenar mudanças entre diferentes times. Em vez de exigir que todos os componentes estejam prontos na mesma janela de deploy, podemos preparar cada parte e ativar o comportamento quando as condições necessárias forem atendidas.
O ponto é projetar a mudança para que a funcionalidade possa ser implantada sem exigir que todas as dependências estejam prontas para sua ativação imediata.
Trade-offs: o código antigo não pode ficar para sempre
Manter dois caminhos de execução tem um custo.
Toda flag adiciona complexidade à aplicação. Precisamos testar os diferentes comportamentos, considerar os dois caminhos durante a manutenção e evitar que as condições se espalhem desnecessariamente pelo código.
Por isso, a limpeza precisa fazer parte da implementação desde o início.
Quando criamos uma flag temporária, devemos planejar também a remoção dela, do código antigo e das verificações de compatibilidade que deixaram de ser necessárias. Abrir o ticket de limpeza no mesmo ciclo ajuda a deixar essa responsabilidade explícita.
Também precisamos entender quem será afetado pela mudança.
Em outro projeto, utilizamos uma flag durante uma migração de dados: usuários que ainda não tinham seus dados migrados continuavam vendo uma versão reduzida da tela, enquanto aqueles que já estavam preparados podiam acessar a experiência nova.
Nesse caso, entender previamente quantos usuários seriam afetados foi tão importante quanto implementar o controle. A flag ajudava a conviver com os dois cenários, mas não substituía a análise de impacto.
Outro cuidado é garantir que o fluxo antigo continue realmente operacional. Não adianta manter o código anterior se uma alteração no banco, no contrato de uma API ou em outro componente compartilhado também tiver quebrado sua execução.
A flag controla a ativação de um comportamento, mas não garante, sozinha, a compatibilidade entre todas as partes do sistema.
Também vale lembrar que desativar uma flag não desfaz o que já aconteceu. Se o novo fluxo gravou dados no banco ou publicou mensagens no Kafka antes da desativação, esses efeitos não são revertidos automaticamente. Dependendo do cenário, pode ser necessário tratar esses dados ou mensagens separadamente.
O que eu levaria para outro time
Se tivesse que resumir o aprendizado em algumas práticas, seriam estas:
- Projetar o código para que o deploy não dependa da ativação imediata da nova funcionalidade.
- Validar os dois fluxos em homologação, não apenas o novo.
- Testar o comportamento da aplicação quando a nova dependência estiver indisponível.
- Liberar a funcionalidade progressivamente quando o cenário permitir.
- Preparar o caminho de desativação para que ele seja uma alternativa real quando uma dependência falhar.
- Planejar desde o início a remoção da flag e do código que deixou de ser necessário.
A empresa já pode ter uma plataforma de feature flags. Isso, por si só, não garante que o time saiba quando usar esse recurso, como manter a compatibilidade entre os fluxos ou quando remover a complexidade temporária.
A maior lição que fica é um deploy não precisa significar que a nova funcionalidade já deve estar disponível para os usuários.
Separar essas duas coisas nos dá mais controle sobre o momento da ativação, mais flexibilidade para lidar com dependências entre times e uma alternativa quando algo não está pronto como esperávamos.
É uma mudança simples na forma de pensar, mas que pode fazer bastante diferença na confiança com que entregamos software.